 Илья Склюев
Лишить работы, украсть данные и написать диплом: что умеют нейросети и как это регулируют
В части стран их пытаются запретить, а юристы разбираются с особенностями работы авторского права по отношению к ИИ
В части стран их пытаются запретить, а юристы разбираются с особенностями работы авторского права по отношению к ИИ
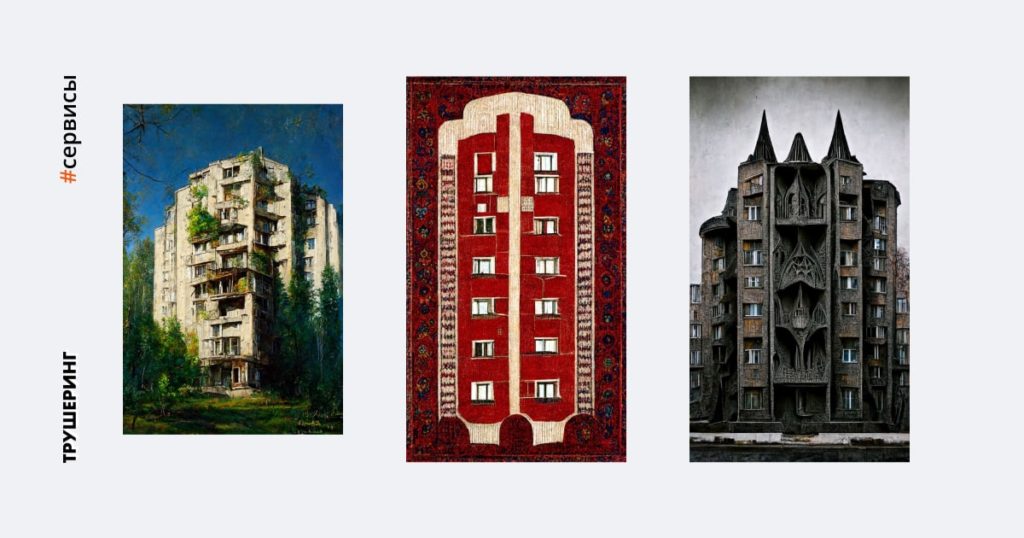
Сейчас на рынке есть несколько ключевых видов нейросетей для генерации:
Правовое положение этих технологий до сих пор остаётся неопределённым. Их использование пытаются ограничить отдельные страны и организации, а юристы пытаются определить их статус в действующем законодательстве.
Персональные данные: злоумышленники могут воспользоваться данными пользователей, если те утекут. Нейросети хранят не только контактные данные пользователей, но и их запросы. Среди них может быть персональная информация (от истории болезни до распорядка дня), части исходных кодов или данные закрытых исследований.
Фейки: нейросети генерируют чересчур реалистичные материалы, в том числе изображения или записи голоса. Беглый поиск по YouTube выдает множество видео, в которых неизвестные авторы генерируют голоса знаменитостей, например президентов США. Потенциально такую запись можно создать для любого человека — и мошенники уже пользуются этим.
Авторское право: не всегда понятно, кому принадлежат права на материалы, полученные с помощью ИИ. Для обучения генеративных моделей используют контент, созданный реальными людьми: картины, фотографии, тексты. Затем нейросети смешивают элементы изученных материалов и на их основе создают что-то новое. При этом итоговый результат может оказаться слишком похожим на исходный контент — и права на него остаются спорными.
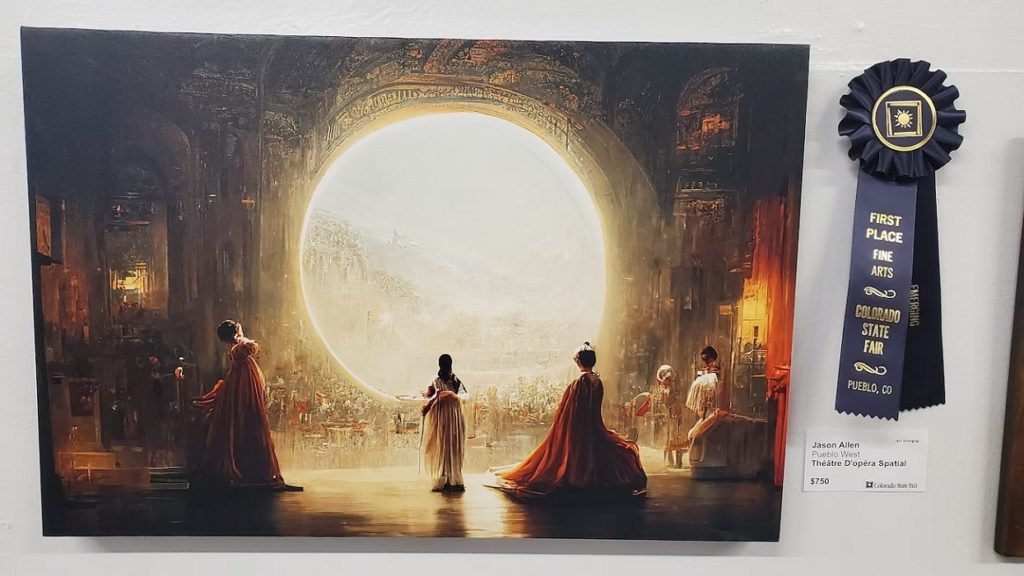
Замена профессий: художники, программисты, сценаристы и представители других профессий требуют ввести регулирование ИИ в их отраслях.
Обучение: нет единых правил, как регулировать использование нейросетей в образовании. Учитывая, что они могут генерировать уникальные текстовые материалы, это может быть проблемой.
Хотя разработка нейросетей началась еще в XX веке, массовый интерес к ним появился только в 2010-е, а распространение — в 2020-е. Пока не существует единых стандартов для регулирования нейросетей — на государственном уровне закон приняла только Италия.
В марте 2023 года она запретила использование ChatGPT после скандала с утечкой данных, но к концу апреля чат-бот разблокировали. Это произошло после того, как разработчики внедрили возможность удалить свои данные и установили проверку возраста.
На момент написания статьи ряд государств, включая Великобританию и Китай, объявили о подготовке законов для регулирования нейросетей. А Евросоюз уже представил первый проект закона. В нём предлагается среди прочего:
И все же пока речь идет в лучшем случае о законопроектах. В основном регулированием сейчас занимаются организации, которые сталкиваются с работой нейросетей, например, фотобанки. В 2022 году Getty Images полностью запретил публиковать сгенерированные ИИ изображения, а Shutterstock начал удалять такие картинки. IT-компании, например Apple, запрещают своим сотрудникам использовать ChatGPT — чтобы они не отправили туда конфиденциальную информацию.
Глава Tesla, SpaceX и Twitter Илон Маск, один из основателей Apple Стив Возняк и другие представители IT-индустрии подписали открытое письмо, в котором призвали приостановить разработку продвинутого ИИ до тех пор, пока в этот процесс не внедрят проверенные независимыми экспертами общие протоколы безопасности.
Одной из самых спорных сфер использования ИИ остается образование – скандал с написанием научных работ там происходят регулярно. В России пока не было случаев, когда университет полностью запрещал использование нейросетей — во всяком случае в публичном поле об ограничениях не рассказывали. При этом, как известно Трушерингу, в одном из сибирских университетов, наоборот, обсуждают внедрение курсов, на которых будут изучать ИИ как инструмент для работы.
В других странах ситуация развивается по-разному. В Японии Токийский университет запретил использовать ChatGPT для написания научных работ. В Британии такие ограничения ввели Кембриджский и Оксфордский университеты, во Франции — Sciences Po, один из ведущих исследовательских университетов страны в области социальных и гуманитарных наук.
По российским законам сгенерированные нейросетями изображения и другой визуальный контент не являются объектами авторского права. Их создала программа, которая не является одушевлённой: то есть результаты её работы формально не принадлежат никому. Технически законодательство не запрещает использовать картинки и другой контент даже в коммерческих целях. Единственным ограничением могут стать условия использования.
Например, Midjourney требует, чтобы пользователь купил подписку для коммерческого использования сгенерированных картинок. Если этого не сделать, то публиковать материалы разрешается только в личных целях и с припиской, что контент создан с помощью этого сервиса. За нарушение пользовательского соглашения владельцы компании могут подать на пользователя в суд.
Пока не было случаев, когда владельцы нейросетей массово подавали в суд на недобросовестных пользователей. И все же важную роль играет и юрисдикция, в которой находится компания — американский сервис вряд ли узнает об использовании сгенерированных ИИ материалов в России. А подача в суд для него в нынешних условиях может оказаться слишком сложной и невыгодной задачей.
Некоторые нейросети не запрещают свободное использование сгенерированного контента. Например, создатели Dall-E 2 разрешают использовать созданные с помощью нее изображения в коммерческих целях. В актуальной версии соглашения они передают все права на сгенерированные материалы самим пользователям. Одновременно с этим они снимают с себя и всю ответственность за содержание контента — человек должен сам следить, чтобы картинки не нарушали законодательство. То же относится и к ChatGPT — у этих сервисов общее соглашение с Dall-E 2.

Компании уже используют нейросети в работе — например, ведут соцсети с помощью чат-ботов. При грамотном запросе с указанием тона текста, его сути и ограничением по количеству слов или знаков, можно быстро сгенерировать пост. То же — с изображениями: вместо того, чтобы тратить деньги на дизайнера, компании создают обложку к рекламе или публикации через словесное описание. Сервисы вроде Stable Diffusion также позволяют обучить нейросеть на собственных примерах, чтобы в результате получить картинку с уникальным стилем. А с помощью ПО, работающего с аудио, можно озвучивать тексты и даже целые книги.
Но если сгенерированные материалы будут слишком похожи на уже существующие работы, — музыку, изображения, видео, тексты, — их авторы могут потребовать компенсацию. Правда, требование могут удовлетворить только при «сходстве до степени смешения» — если суд посчитает, что работы можно легко перепутать из-за шрифтов, общих форм и других совпадений. Столкнуться с иском можно и если использовать в коммерческих целях изображения или видео с лицензированными образами. Например, если создать картинку с Суперменом в костюме Бэтмена.
Чаще всего пользователи арендных самокатов нарушают правила в двух ситуациях: когда не спешиваются на пешеходном переходе и когда едут вдвоём на одном устройстве. Москва научилась такие нарушения замечать и работать с ними — камеры с нейросетями передают данные операторам, а те предупреждают и штрафуют. Разбираемся, что именно фиксирует город и почему нарушений становится меньше.
Автоюрист Александр Беленко открывает каршероводам законный механизм снижения размера штрафов.
 Редакция
 Автоюрист Александр Беленко